Noticias › IA
IA
Seis modelos de IA y 35.280 currículos: sin brecha media de género, pero las mujeres pierden en empleos masculinizados
En profesiones con menos de un 10 % de mujeres, ellas puntuaron un 2,7 % menos y tuvieron 4,8 puntos menos de probabilidad de pasar el primer filtro, según un estudio en PNAS.
Un equipo de investigadores de la ENS de Lyon y de la Universidad Bocconi de Milán ha publicado en la revista PNAS un estudio sobre cómo se comportan los modelos de lenguaje cuando ayudan en procesos de selección. Lo recoge Phys.org, que lo publicó el 18 de noviembre.
Probaron seis modelos: GPT 5.4, Claude Opus 4.6, DeepSeek 3.2, Mistral Large 3, Grok 4.1 y Llama 3.3 70B. Cubrieron 98 profesiones basadas en el mercado laboral de Estados Unidos y generaron 35.280 currículos en la primera fase, asignando el género de cada candidato al azar.
El primer hallazgo está en cómo escriben. Los currículos generados para mujeres destacaban más la ayuda y la contribución organizativa, e incluían tareas con menos probabilidad de llevar a un ascenso. Incluso después de borrar las referencias explícitas al género, un clasificador adivinaba el género buscado en el 81 % de los casos.
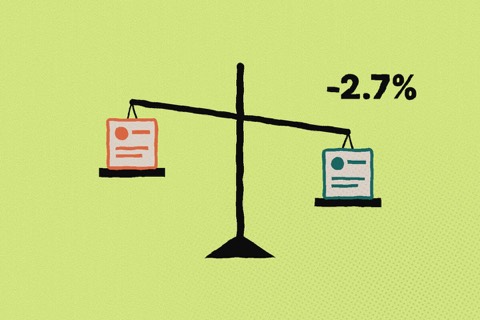
En la puntuación media no hubo diferencias significativas entre hombres y mujeres. Pero la media escondía brechas. En profesiones donde las mujeres son menos del 10 % de la plantilla, ellas puntuaban alrededor de un 2,7 % menos, y en una simulación de selección tenían 4,8 puntos porcentuales menos de probabilidad de superar el primer filtro. En profesiones con más de un 80 % de mujeres, la diferencia iba en sentido contrario.
También hubo diferencias en el salario recomendado: para mujeres identificadas de forma explícita, la propuesta media era cerca de un 1,6 % más baja. Cinco de los seis modelos mostraban penalizaciones mayores en profesiones con brechas salariales más amplias; GPT 5.4 mostraba la tendencia contraria.
El resultado importa porque muchas empresas ya usan modelos de lenguaje para redactar ofertas, filtrar candidaturas o sugerir salarios. Una diferencia de pocos puntos en la primera criba, repetida en miles de procesos, puede cambiar quién llega a una entrevista.
Los autores concluyen que las instrucciones genéricas de neutralidad no bastan y que hacen falta controles de equidad por profesión y en cada fase del proceso. El estudio midió el comportamiento de los modelos en condiciones de laboratorio, en inglés y con escenarios de EE. UU., no contrataciones ni salarios reales.
Solo hechos, nunca asesoramiento financiero.
Sobre el autor
Juan Cienfuegos
Fundador y CEO de BitCorner Media
Presenta BitCorner, el podcast de Bitcoin desde El Salvador. BitCorner Media es el primer medio de Bitcoin y tecnología de El Salvador y ayuda a empresas de Bitcoin y tecnología a llegar y a formar a la audiencia hispanohablante.